В ноябре Google выкатил масштабный апдейт, охвативший сразу все уровни работы с ИИ: от потребительских чатов до профессиональных API и агентных сред разработки. Чтобы не заблудиться в «химической» номенклатуре (Hydrogen, Argon, Neon, Carbon), важно уяснить фундаментальный принцип: каждая модель заточена под конкретную нагрузку, а доступ к ней зависит от точки входа.
У Google сформировались три ключевые среды для работы с нейросетями:
- Gemini (веб-версия и мобильное приложение) — потребительский диалоговый сервис для повседневной работы;
- Google AI Studio — профессиональная инженерная среда для тестирования системных промптов, проверки архитектуры и работы через API;
- Antigravity — агентная рабочая станция для автономной разработки, системного кодинга и исследований.
Они принципиально различаются набором подключенных моделей, дневными квотами и логикой исполнения. Разберём каждую модель и её реальное место в рабочем пайплайне.
1. Сервис Gemini: скорость, архитектурный кодинг и новый флагман Neon
В пользовательском интерфейсе Gemini произошло разделение ролей на сверхбыстрый отклик и глубокую инженерную проработку:
Быстрая рабочая лошадка нового поколения
Вышла 12 ноября 2026 года и официально пришла на смену Gemini 3.8 Flash. Благодаря оптимизации весов и спекулятивному декодированию она генерирует токены в 2,5 раза быстрее предшественника при полном сохранении строгости рассуждений.
В задачах написания бойлерплейт-кода, модульных тестов и пошагового выполнения агентных сценариев Hydrogen стала стандартом де-факто.
Модель для кода, анализа и рефакторинга
Спроектирована для глубокого и точного решения сложных задач в разработке. Она безупречно удерживает взаимосвязи в многофайловых проектах, разбирается в структурах БД и проводит рефакторинг без потери граничных условий. Доступна в Gemini подписчикам Google AI Pro, но лимиты на неё держат жесткими.
Флагманский баланс: интеллект уровня Carbon на скоростях Flash
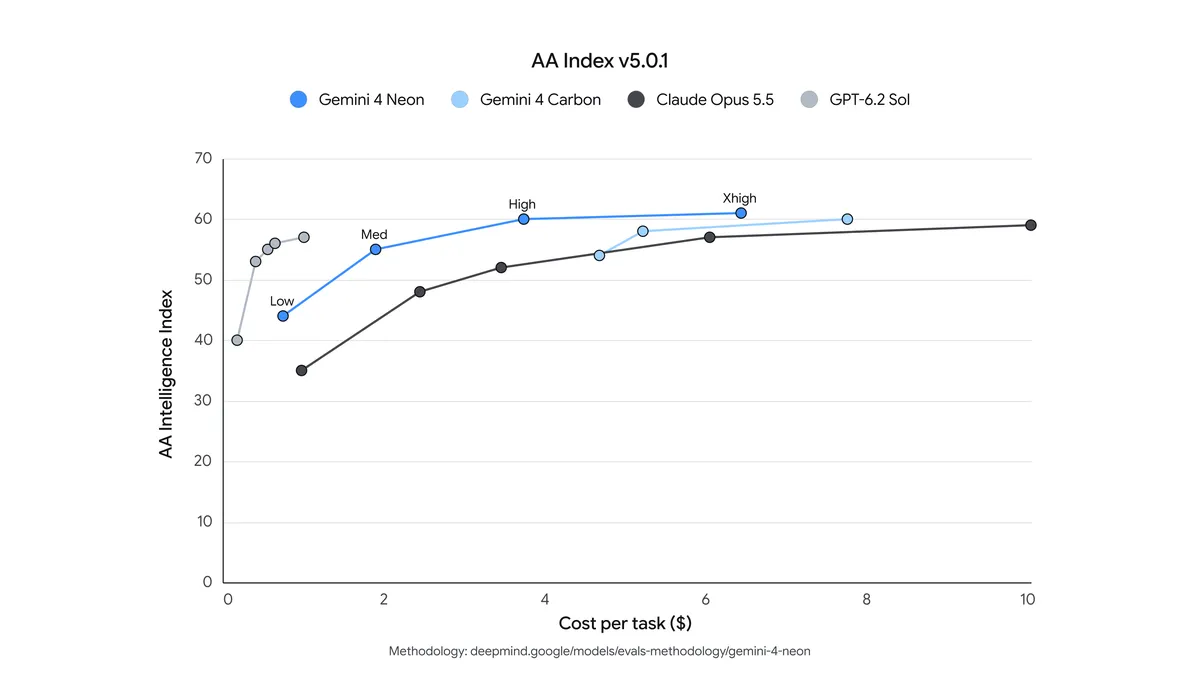
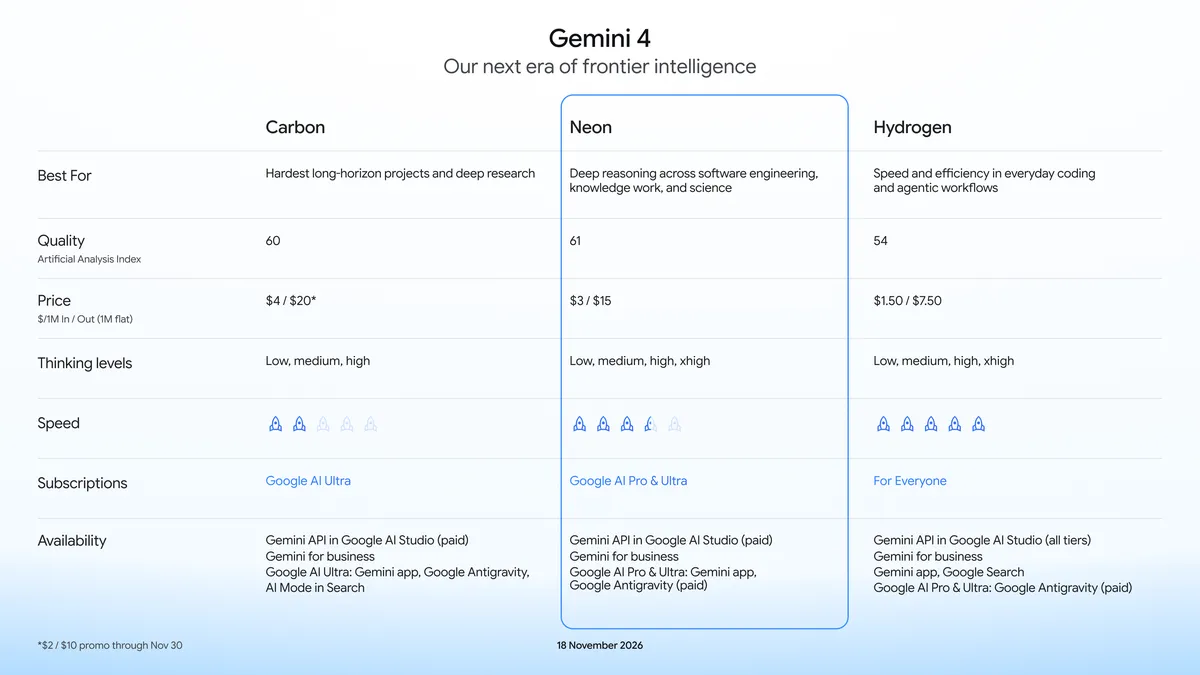
Прямо во время подготовки обзора Google DeepMind анонсировал Gemini 4 Neon. Модель адаптирована на базе флагманской ветки Carbon, но оптимизирована по цене и скорости инференса.
По независимым тестам Neon показала минимальный уровень галлюцинаций среди всех протестированных моделей Google. Она заняла первую строчку в Artificial Analysis Coding Agent Index и Zapier AutomationBench, продемонстрировав исключительную устойчивость: модель чутко схватывает замечания пользователя прямо по ходу многошагового диалога, не ломая общий контекст.
2. Google AI Studio: тяжёлые вычисления и революция Decision 1
В инженерной консоли Google AI Studio по-прежнему доступна надёжная Gemini 3.8 Flash, а также появились Hydrogen и Argon. Но главный интерес вызывают две принципиально разные новинки:
Максимальный интеллект для науки, безопасности и сложной инженерии
Самая мощная reasoning-модель в арсенале Google. Построена на базе архитектуры Argon, но использует расширенный пул токенов внутреннего размышления (thinking tokens) и автоматические циклы самоверификации.
Carbon создана для долгосрочных задач: математическое моделирование, закрытие сложных багов (лидер в CursorBench 4.0), аудит безопасности и координация многоагентных роёв.
Дискриминатор без генерации текста: 1000 проверок за 200 миллисекунд
Это не чат-бот. Модель вообще не генерирует текст (zero output tokens) и не ведёт беседы. Вместо посимвольной генерации Decision 1 работает как сверхоперативный классификатор через единый прямой проход (Single Forward Pass).
Она принимает на вход мультимодальный массив: многостраничные PDF, аудиофайлы, видео, снимки экранов или код. И параллельно отвечает на до 1 000 типизированных вопросов в формате «Да / Нет», скоринговых баллов или выбора из заданного списка с задержкой всего 150–250 мс.
Где незаменима: валидация политик безопасности перед отправкой в LLM, селектор инструментов для автономных агентов, премодерация контента и быстрая сортировка документов без переплаты за токены генерации.
3. Google Antigravity: агентная среда и новый режим Knowledge Work
В среде автономных агентов Google Antigravity основной рабочей лошадкой пока остаётся проверенная временем Gemini 3.8 Flash, усиленная связкой с Claude Sonnet и Opus для критичных архитектурных веток. Интеграция моделей поколения Gemini 4 уже стартовала, но разворачивается поэтапно.
Ключевая новость Antigravity: запущен режим Knowledge Work. Это адаптивный, упрощённый интерфейс для аналитической работы, синтеза исследований, обработки документов и написания текстов. Antigravity теперь полноценно полезен продакт-менеджерам, аналитикам и предпринимателям, которым не нужен терминал или код, но критична агентная автоматизация рутины.
Сводная таблица: параметры, бенчмарки и назначение моделей
| Модель | Тип и архитектура | Контекст | Скорость / Задержка | Стоимость / Лимиты | Оптимальный сценарий |
|---|---|---|---|---|---|
| Hydrogen | Сверхбыстрая генеративная | 1M токенов | ⚡ В 2.5× быстрее Flash | Низкая / Gemini, AI Studio | Повседневные промпты, модульные тесты, агентные субагенты |
| Argon | Инженерная рабочая модель | 1M токенов | ⏳ Средняя (глубокий код) | Средняя / Google AI Pro | Архитектура сервисов, рефакторинг репозиториев, сложная логика |
| Neon | Флагманский баланс (Carbon-based) | 1M (64K out) | ⚡ Высокая (4 уровня thinking) | $3 in / $15 out за 1M | Frontier-разработка, агентные пайплайны, минимум галлюцинаций |
| Carbon | Глубокий reasoning флагман | 1M+ токенов | 🧠 Медленная (длинные цепочки) | Высокая / Google AI Studio | Научные вычисления (STEM), аудит уязвимостей, аудит архитектуры |
| Decision 1 | Мультимодальный дискриминатор | 256K токенов | ⚡ Мгновенная (150–250 мс) | Zero output tokens (очень дёшево) | Классификация, проверка регламентов, роутинг запросов (Да/Нет) |
| 3.8 Flash | Проверенная базовая модель | 1M токенов | ⚡ Высокая | Бесплатно / Широкие лимиты | Текущая база в Antigravity, парсинг логов, рутинный поиск |
Личный опыт: как распределять задачи и не упираться в лимиты
Чтобы ежедневно выжимать максимум из инструментов без простоя и лишних подписок, я применяю проверенную схему разделения ролей:
- Повседневная рутина, поиск и агенты: работаю в Antigravity на Gemini 3.8 Flash. Режим Knowledge Work закрывает сортировку баз знаний, анализ заметок и генерацию драфтов.
- Архитектурные решения и системный дизайн: открываю интерфейс Gemini и переключаюсь на Argon или Neon. Здесь формулируются фундаментальные сущности и алгоритмы.
- Аудит кода и сложные баги: использую Carbon в Google AI Studio. За счёт глубокого рассуждения модель безупречно отлавливает ошибки типизации и логические нестыковки.
- Фильтрация и маршрутизация: подключаю Decision 1 через API для оценки входящих данных, чтобы не тратить дорогие генеративные токены там, где нужен лишь ответ «Да или Нет».
Главный практический вывод: квоты и лимиты запросов в Gemini, Google AI Studio и Google Antigravity учитываются раздельно. Если грамотно чередовать точки входа под разные классы задач, вам гарантированно хватит ресурсов на любой рабочий день без блокировок.
Часто задаваемые вопросы (FAQ)
Hydrogen быстрее примерно в 2,5 раза благодаря спекулятивному декодированию. При этом модель точнее пишет код, поддерживает 1M контекста и позволяет разработчикам регулировать глубину рассуждений (thinking level).
Neon даёт 90–95% интеллектуальной мощи Carbon, но работает значительно быстрее и стоит на 17–32% дешевле ($3 за 1M входных токенов против $4.5+ у тяжелых сетей). По тестам она демонстрирует наименьший уровень галлюцинаций в линейке.
Обычные LLM тратят секунды на генерацию текста и стоят дороже. Decision 1 за один проход (150–250 мс) валидирует файл, картинку или видео и возвращает структурированные решения по 1 000 параметрам сразу с нулевыми токенами вывода.
В интерфейсе Gemini доступ открывается при активной подписке Google AI Pro. Разработчики также могут получить доступ к моделям через API в консоли Google AI Studio.
Да, развёртывание уже идёт. Первой в агентный контур поступит Hydrogen как быстрый субагент-исполнитель, за ней последует Neon для задач планирования и координации.
Официальные материалы Google DeepMind:
- Официальный релиз ядра: Google Blog — Introducing Gemini 4 Hydrogen
- Флагманский анонс: Google Blog — Introducing Gemini 4 Neon
- Канал автора с инсайдами и практикой: Telegram-канал @lukafund